正在打开每日关注
TypeSafe 官方 Agent Skill:教会编码代理用 Jev 做结构化判断
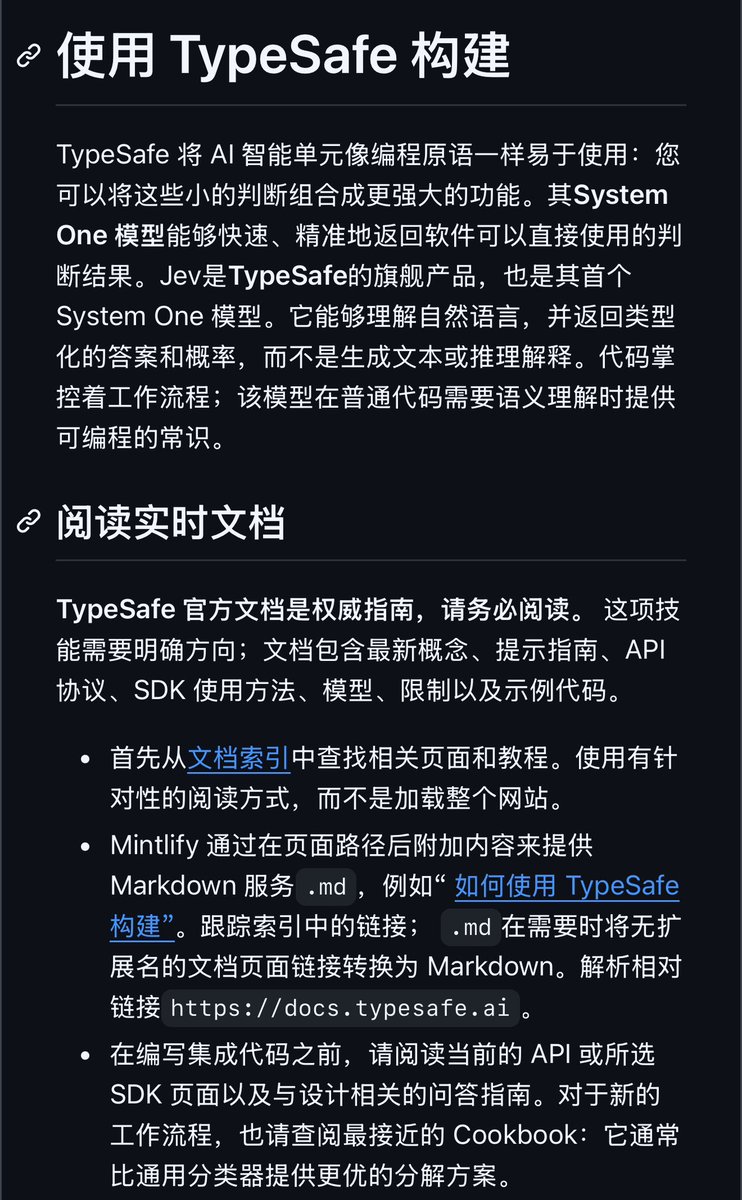
TypeSafe 官方 Skill 把多问合并为单次 System One 调用,成本降 12.2x、速度升 10x,代码掌权、模型只出概率答案。
来源摘录
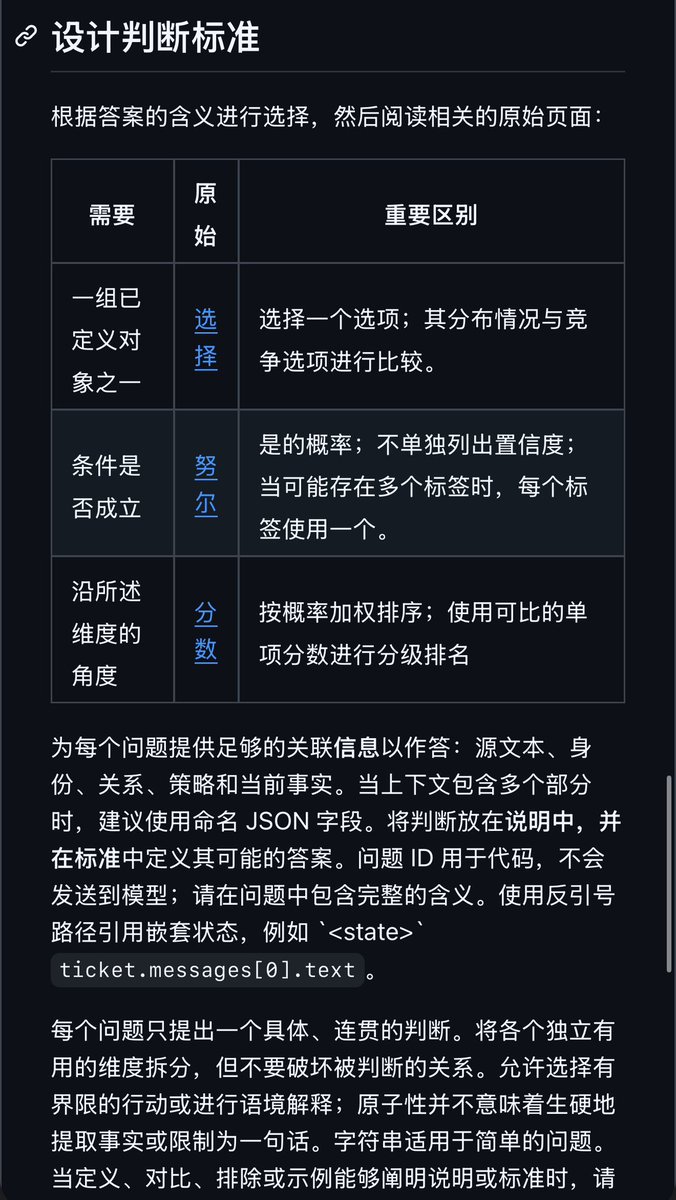
🔥还有谁不知道?13 问并成 1 次调用,账单打到 1/12.2,2.71 秒压到 0.27 秒! TypeSafe 官方 skill 刚教会 Claude Code 怎么在 Jev 上构建。 这个 skill 把顺序硬改成:读文档 → 写行为 → 列判断 → 一次请求 → 代码做决策 核心亮点: 🔹3 个原语一次看懂:Choice 选、Noul 判真假、Score 打分 🔹13 个问题塞进 1 次调用:成本降 12.2x,速度升 10x 🔹重排证据:Top1 命中从 5% 拉到 18%,Top10 从 38% 拉到 62% 🔹11 条指令每条都对应一种真实翻车:猜字段、串行提问、把 confidence 当许可、阈值直接抄 cookbook 关键操作: 1️⃣装 skill(二选一,别装两份) claude plugin marketplace add typesafe-ai/skills claude plugin install typesafe@typesafe-ai 或其他 Agent:npx skills add typesafe-ai/skills --skill typesafe-ai 2️⃣设 TYPESAFE_API_KEY,密钥只放环境变量,不进仓库、不进 prompt 3️⃣先让 Agent 读 https://t.co/sPWbstCT6j,再读 API / 原语页。禁止凭记忆填字段 4️⃣先写一行行为:应用展示什么、选择什么、改什么、交什么 5️⃣把判断拆成「一问一事」。规则、计算、查表、执行、策略全部留在普通代码里 6️⃣每个 Choice 必须带 no-match。同一 state 的问题打进一次请求,只有答案决定下一跳时才拆第二次 7️⃣问题和阈值写进同一份可审文件。阈值必须用自己的标注集调,并钉死模型版本 8️⃣失败时记下 state、问题、答案,再标:缺证据 / 模型 / 代码 / 服务 Jev 不是写代码的 LLM,是 70–500ms 的 System One 判断器。代码掌权,模型只给带概率的答案。 Github:https://t.co/MXwLnvW1sj #Jev #TypeSafe #ClaudeCode #SystemOne #AgentSkill #LLMOps
💥惊了!JEMM-27B全方位开源杀到 !85.7%碾压Laya、工具调用93.3%反超Jev! Qwen基座专项多模态训练后的JEMM-27B,把图文决策、工具调用、网页操作和审核一起卷进同一个开放模型:不只比Jev 1.13准,还比它更快,JevBench公开题也明显甩开Laya。 核心亮点 🔹原生吃文字+图片,候选选择 / 条件判断 / 打分可直接进Agent决策环节 🔹工具调用准确率 88.7% → 93.3%;截图网页任务 36.0% → 54.6%(+18.6pp,Jev只看文字) 🔹5种文字请求配置延迟全面低于Jev,单题中位数约0.3秒,汇总延迟降31.2% 🔹JevBench 231公开题答对198题,准确率85.7%,高于Laya(58.4%)、Kev、Semlf、Von 🔹对比表里几乎是唯一同时具备:图片输入、任务训练、相对Jev效果更好、延迟更低、开放权重 上手步骤 1️⃣Hugging Face搜 JEMM,下载27B权重:https://t.co/1Q5E10TaI8 2️⃣按仓库README装依赖(建议先对齐官方推理适配) 3️⃣加载Qwen基座+JEMM权重,按示例传入文本/截图 4️⃣用选择题、判断、评分接口接进现有Agent工作流,先跑工具调用和网页截图任务验证 推理代码和权重点Hugging Face,搜 JEMM 就能找到。 #JEMM #Jev #Laya #开源大模型 #多模态 #Agent #HuggingFace #GitHub

深度解析
是什么 TypeSafe 官方开源的 Agent Skill(MIT,2.3k stars),把 Jev——一个 70–500ms 的 System One 结构化判断模型——的正确用法固化为 Claude Code 等编码代理可直接执行的指令集;被引用推文则宣传对标 Jev 的开源多模态模型 JEMM-27B。
核心设计 强制工作流「读文档→写行为→列判断→一次请求→代码做决策」;Choice/Noul/Score 三个原语分别负责选项选择、真假判断与打分,规则、计算与执行留在普通代码里。同一状态的问题合并进单次调用,官方 parallel_questions cookbook 显示 13 问成本降 12.2x、延迟从 2.71s 压到 0.27s;重排序 cookbook 将 top-1 命中从 5% 提到 18%、top-10 从 38% 提到 62%。11 条指令逐一对应猜字段、串行提问、误把 confidence 当许可、阈值照抄 cookbook 等真实翻车模式。
关键洞察 亮点不在模型本身,而在模式:把领域工程经验产品化为可安装的 skill,配以「代码掌权、模型只给带概率的答案」的清晰架构边界,让判断类 AI 能力以低延迟、可审计的方式嵌入常规软件。
边界与风险 各项数字均来自官方自测 cookbook,阈值必须用自己的标注集校准并钉死模型版本;被引用的 JEMM-27B 在 Hugging Face 搜索中仅见一个 26 下载量的同名模型,85.7%、93.3% 等对比数据无法核实,营销成分需警惕。