正在打开每日关注
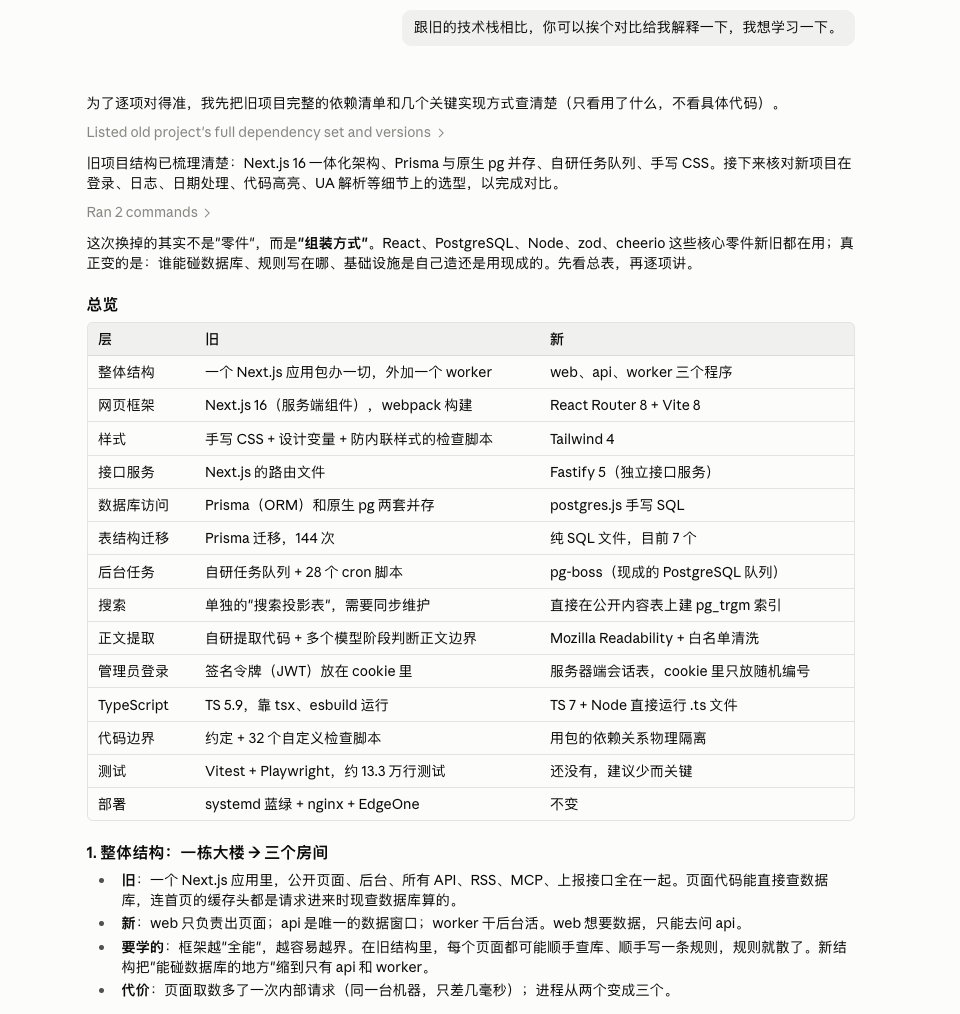
蒸馏旧项目为功能文档,用最新模型原地重写
提出将遗留代码库蒸馏成功能文档,再用最新大模型原地重写,比重构屎山更高效。
来源摘录
比重构屎山可能更高效的方式: 直接将源项目库蒸馏成功能文档,然后直接用最新的模型原地重写。。。🤦♂️🤦♂️🤦♂️ https://t.co/8QNcqkC2y6

深度解析
是什么:这条推文给出一条遗留系统迁移的替代路径——先把旧项目源码「蒸馏」成一套功能文档,再把文档交给最新大模型原地重写,以替代传统的逐行重构屎山。三个捂脸 emoji 暗示作者也觉得该做法「简单到荒谬,但可能真的高效」。
为何可能成立:传统重构必须背负历史包袱——补丁、隐式耦合与说不清的依赖,成本随规模线性上升;而大模型恰恰擅长从干净上下文做生成、不擅长理解混乱旧代码。文档蒸馏相当于把旧系统行为压缩成高质量上下文,作为「中间表示」重建代码意图,让模型从需求而非脏代码出发。
关键洞察:文档成为迁移的一等产物,旧代码降级为参考实现。Joel Spolsky 关于全量重写必丢隐含知识的经典论断被部分化解,但前提是蒸馏文档足够覆盖边界条件,且测试与行为比对必须作为真正的安全网。
边界与风险:蒸馏必然有信息损耗,未文档化的分支、并发与兼容行为极易回归;大型系统宜按模块增量绞杀式迁移而非一次性原地重写;数据与状态迁移不在此法覆盖范围内,需另行规划。