正在打开每日关注
一份提示词跨 Gemini/Grok/GPT Image 生成图与视频
博主分享四步工作流:上传图片后粘贴同一段提示词,即可在多家模型上生成图像和视频。
来源摘录
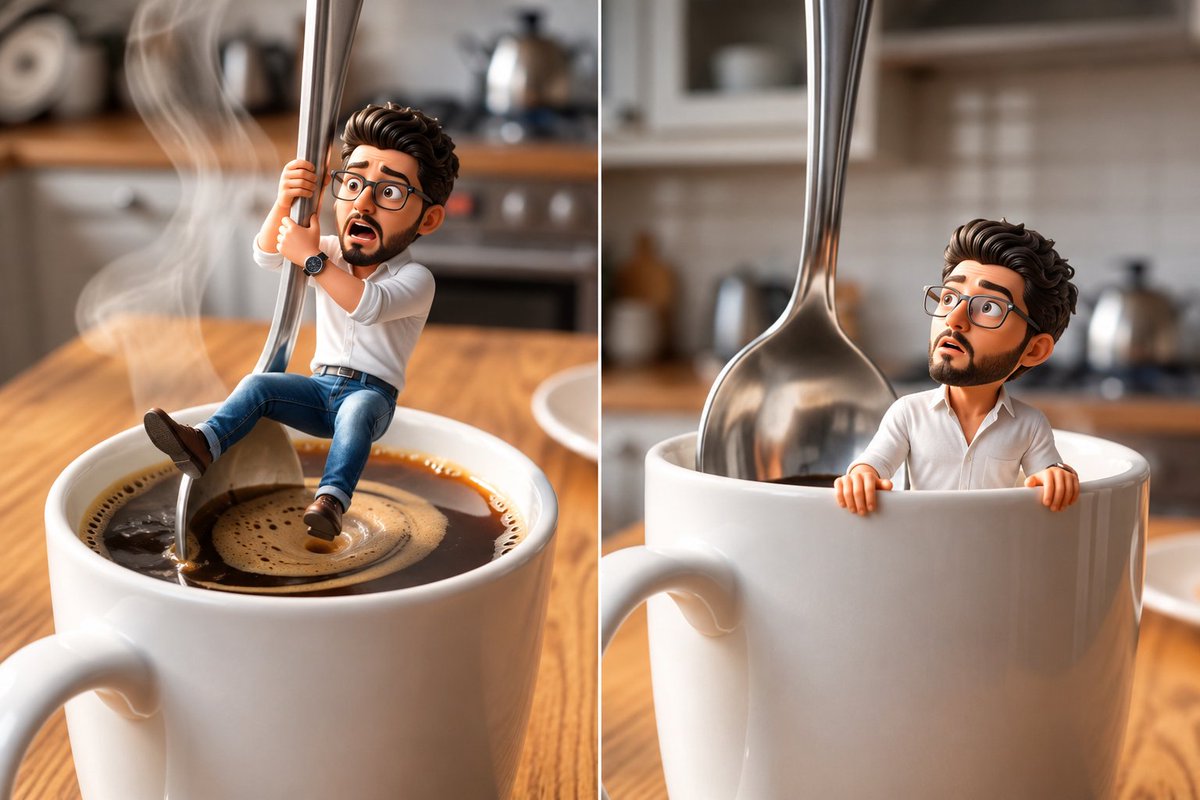
① Open Gemini, Grok or GPT Image 2.0 ② Upload your image ③ Paste the prompt ④ Generate your image and video Prompt given below ⤵️ https://t.co/2CZSR3kSkf
深度解析
是什么:这是一条典型的“提示词分享”型推文。作者给出一个四步工作流:打开 Gemini、Grok 或 GPT Image 2.0,上传自己的图片,粘贴作者提供的提示词,即可生成图像和视频,完整 Prompt 放在外链中。
核心价值:它强调“一份提示词、多个模型通用”的可移植性——同一段 Prompt 可在 Google、xAI、OpenAI 三家的图像/视频模型上复用,把多模态生成的使用门槛降到复制粘贴级别,配合图生图、图生视频能力快速产出内容。
关键洞察:其一,当多模态模型能力趋同,竞争焦点正从模型本身转向提示词模板与分发渠道,这类账号本质是在做“提示词策展”,靠标准化教程获取流量;其二,图生视频已成为内容创作的热门形态,“效果对比 + 四步教程”在社交媒体上是一套成熟的传播模板。
边界与风险:教程未说明该提示词在不同模型、不同版本上的效果差异与稳定性;上传含人物肖像的图片存在隐私与版权风险;模板化生成也会加剧视觉内容同质化。整体属于 AI 应用技巧类内容,而非设计方法论。