正在打开每日关注
用上下文蒸馏构建分层 Agent 协作架构
通过大模型输出指导小模型,形成编排、实现与审查分工的 Agent 工作流。
来源摘录
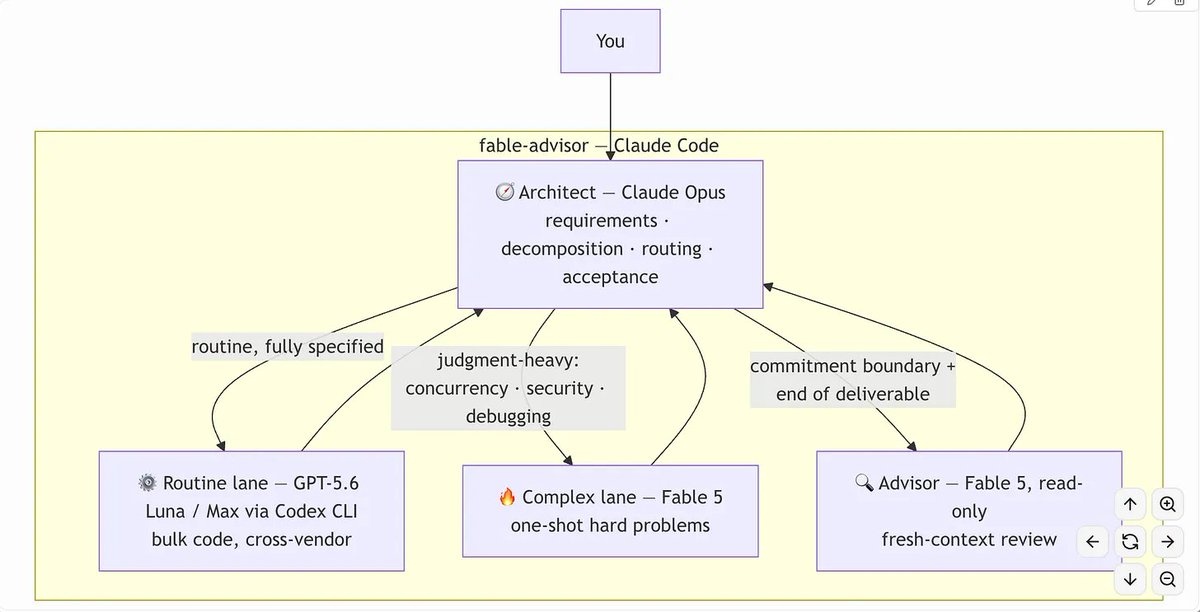
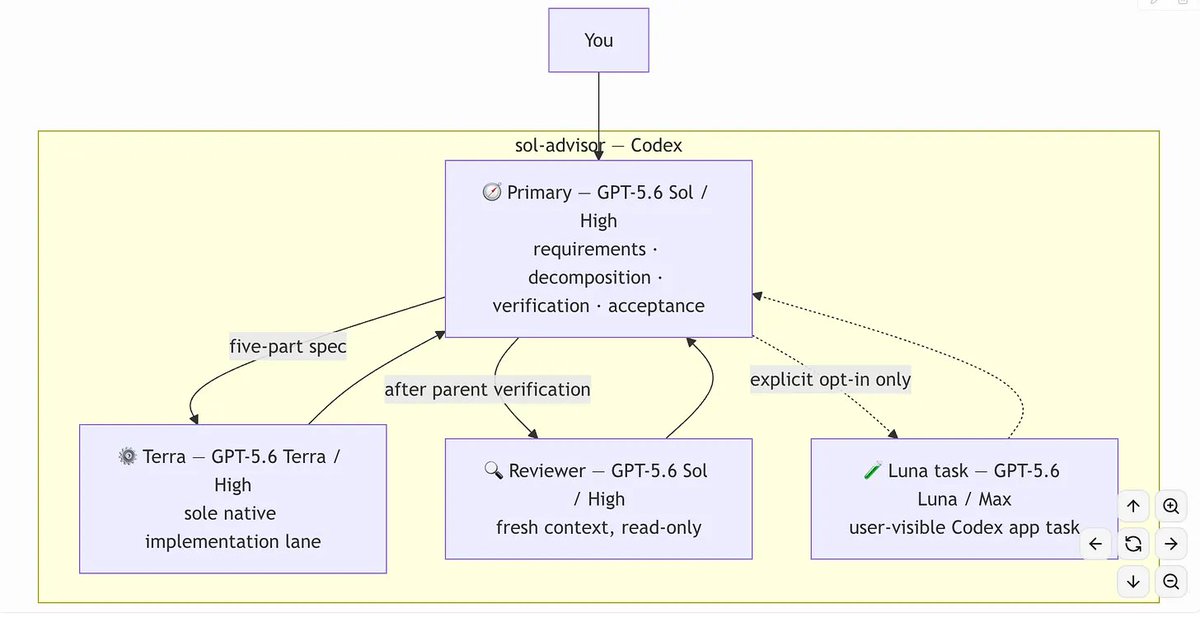
In-context distillation: using the outputs from a larger more expensive model to guide a smaller, cheaper one. That's how the 'fable-advisor' and 'sol-advisor' Orchestrator -> Implementer -> Advisor pattern works. Wrote about how you can take advantage of that 👇
深度解析
是什么 这条内容介绍“上下文蒸馏”:先让更大、更昂贵的模型完成理解、拆解、路由和验收,再把结构化结果交给更小、更便宜的模型执行,从而降低 Agent 工作流成本。图中给出了 fable-advisor 与 sol-advisor 两种编排方式,本质都是 Orchestrator → Implementer → Advisor 的分层协作。
核心设计 中心角色负责需求分析、任务分解、模型选择与验收;常规且规格明确的工作交给 GPT-5.6 Luna/Max 或 Terra,复杂的一次性问题则路由给 Fable 5。实现、主任务和审查分别占据独立节点,审查使用 fresh context 且只读,减少实现过程对判断的污染。第二张图还强调“after parent verification”与“explicit opt-in only”,把验证门槛和高风险能力控制在明确边界内。
关键洞察 真正可复用的不是某个模型名称,而是把昂贵推理集中在路由和验收环节,把廉价模型用于规模化执行,并用角色隔离提升可审计性。
边界与风险 蒸馏结果若遗漏隐含约束,后续小模型会稳定地执行错误计划;并发、安全和调试类任务也不能仅按“常规代码”处理。模型切换、验收标准、人工承诺边界都需要显式定义和持续验证。