正在打开每日关注
把技术书转成可按需调用的 Agent Skill
book-to-skill 将多格式技术资料分层提取为按需加载的 Agent Skill,降低长文档上下文成本。
来源摘录
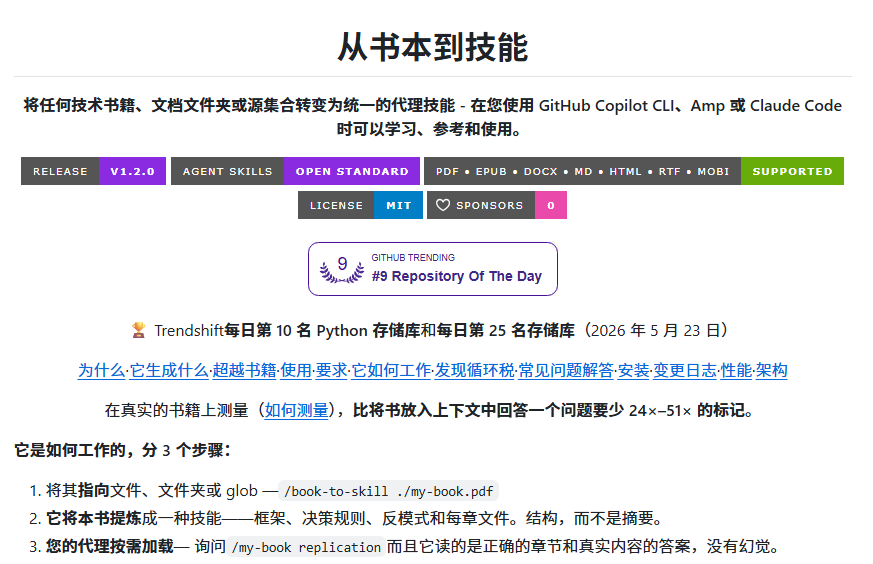
把 600 页的技术书直接扔给 AI,不仅消耗 Token,AI 还经常瞎编乱造或者漏掉关键细节。 virgiliojr94/book-to-skill 这个开源工具的解法很硬核:它能把 PDF/EPUB 技术书切碎分层,自动提取核心框架、概念图和章节索引,直接转化成 Claude Code / GitHub Copilot CLI / Amp 的 Agent Skill。需要时按需调取特定章节,能节省 20-50 倍的 Token 开销,直接把技术书变成你随时调用的“底层代码库”。 💡 核心价值与功能 1️⃣ 两层架构拒绝幻觉:提取生成一个约 3k Token 的总览文件(含思维模型与索引)+ 各章节独立文件(按需调用,约 1k Token/章)。AI 不再需要盲目全书检索,而是直接精准定位章节作答。 2️⃣ 多格式全平台支持:除了 PDF,还支持 EPUB、DOCX、Markdown 甚至整个架构文档/内部 Runbook 文件夹。完美适配符合 Agent Skills 开放标准的终端工具。 3️⃣ 本地解析隐私安全:提取逻辑纯本地运行,不上传私有数据。官方支持 Docling 解析,能完美保留代码块与 Markdown 表格。 ⚠️ 使用提醒 & 适合人群 适合人群:常看技术类/架构类硬核大部头、需要把团队内部 ADR/架构文档转化为 AI 知识库的开发者与独立创作者。 实测提醒:纯文本大部头推荐用默认的 pdftotext 提速;如果是带大量代码和表格的技术书,建议按提示配合安装 Docling。跑完后直接在 Claude Code 里打 /your-book-slug 就能开始调用。 把好书变成 AI 的神经反射,比让它死记硬背高效得多。建议经常敲代码查文档的朋友 clone 备操。 🔗 项目地址:https://t.co/2LIgojVU7h
深度解析
是什么 book-to-skill 是一个 Python 开源工具与工作流,将 PDF、EPUB、DOCX、Markdown、HTML、RTF、MOBI,以及文档目录或 glob 输入,转换为符合 Agent Skills 开放标准的技能目录。它不是把整本书直接塞进模型上下文,而是把资料结构化后,供 Claude Code、GitHub Copilot CLI 和 Amp 按需读取。
核心设计
README 描述了确定性的 Python 提取器与规范驱动的生成器两部分:先抽取文本和元数据,再生成约 4,000-token 的 SKILL.md,其中包含心智模型与章节索引;同时生成按章节拆分的 Markdown、glossary、patterns 和 cheatsheet。查询时只加载相关章节,项目称在真实书籍测量中可比上下文倾倒少 24×–51× token。
关键洞察 它把一次性的“发现循环”成本前置,将全文搜索升级为框架、决策规则、反模式和章节引用。输入范围也从书籍扩展到 ADR、Runbook、研究资料、规范及品牌或设计系统文档。代码、表格密集的 PDF 适合 Docling,纯文本则优先使用 pdftotext,体现了按文档类型选择解析器的思路。
边界与风险 24×–51× 是项目给出的实测指标,不是所有书籍和问题的普遍保证。效果依赖文本抽取、章节识别与生成质量;扫描 PDF 没有文本层时仍需先 OCR,MOBI/AZW 等格式依赖 Calibre。源文档更新、可选依赖和切分策略也可能影响稳定性,关键结论仍应回到原文核对。